✅ L'essentiel
- Formule de Bayes : P_B(A)=\dfrac{P_A(B)\times P(A)}{P(B)}, avec P(B)=P(A)\,P_A(B)+P(\overline{A})\,P_{\overline{A}}(B) (probabilités totales). P_B(A) et P_A(B) sont deux nombres différents.
- Loi binomiale \mathcal{B}(n,p) : P(X=k)=\dbinom{n}{k}p^k(1-p)^{n-k}, E(X)=np. Loi géométrique : P(X=k)=(1-p)^{k-1}p, E(X)=\dfrac{1}{p}.
- Loi à densité : P(a \leq X \leq b) = \displaystyle\int_a^b f(x)\,dx (une aire). Loi exponentielle : P(X \leq t)=1-e^{-\lambda t}, E(X)=\dfrac{1}{\lambda}.
- Droite des moindres carrés y=ax+b : a=\dfrac{\text{cov}(X,Y)}{V(X)}, b=\bar{y}-a\bar{x}. Elle passe toujours par le point moyen G(\bar{x};\bar{y}).
📖 Rappel — Variable aléatoire, loi, espérance
En première : une variable aléatoire associe un nombre à chaque issue ; sa loi est le tableau des , de somme 1 ; est sa moyenne à long terme.
Une épreuve de Bernoulli a deux issues, succès () ou échec (), et sa répétition indépendante se lit sur un arbre où l'on multiplie le long d'un chemin. La loi binomiale et la loi géométrique ne font que compter ces chemins.
📖 Propriété — Inverser un conditionnement : la formule de Bayes
Rappel de première : est la probabilité de sachant que est réalisé, et — on multiplie le long d'une branche de l'arbre. La formule des probabilités totales additionne les chemins qui mènent à :
Souvent, l'énoncé donne et la question porte sur l'inverse, . Comme s'écrit dans les deux sens, , d'où la formule de Bayes :
Vocabulaire des tests de dépistage ( = « malade », = « test positif ») :
- sensibilité : un malade est détecté ;
- spécificité : un non-malade a un test négatif ;
- valeur prédictive positive (VPP) : un test positif signale vraiment un malade ;
- valeur prédictive négative (VPN) .
✏️ Exemple — Un bon test, et pourtant…
Ne pas confondre et . « des malades sont positifs » ne veut pas dire « des positifs sont malades » : ici, c'est . C'est l'objectif central du chapitre, et une erreur fréquente jusque dans les tribunaux (le « sophisme du procureur »).
📖 Lois discrètes usuelles
| Loi | Espérance | |
|---|---|---|
| Uniforme sur | ||
| Bernoulli | si , si | |
| Binomiale | ||
| Géométrique | () |
La loi géométrique donne le rang du premier succès dans un schéma de Bernoulli. C'est la loi discrète sans mémoire : — avoir déjà attendu essais ne change rien à la suite.
📖 Lois à densité
suit une loi de densité (avec et d'aire totale ) si, pour tous :
Une probabilité est donc une aire sous la courbe de . En particulier : seuls les intervalles ont une probabilité non nulle.
Loi uniforme sur : sur , et .
Loi exponentielle de paramètre : sur .
C'est la loi sans mémoire continue : . Elle modélise les durées de vie sans usure (désintégration radioactive, panne d'un composant électronique).
📖 Statistique à deux variables
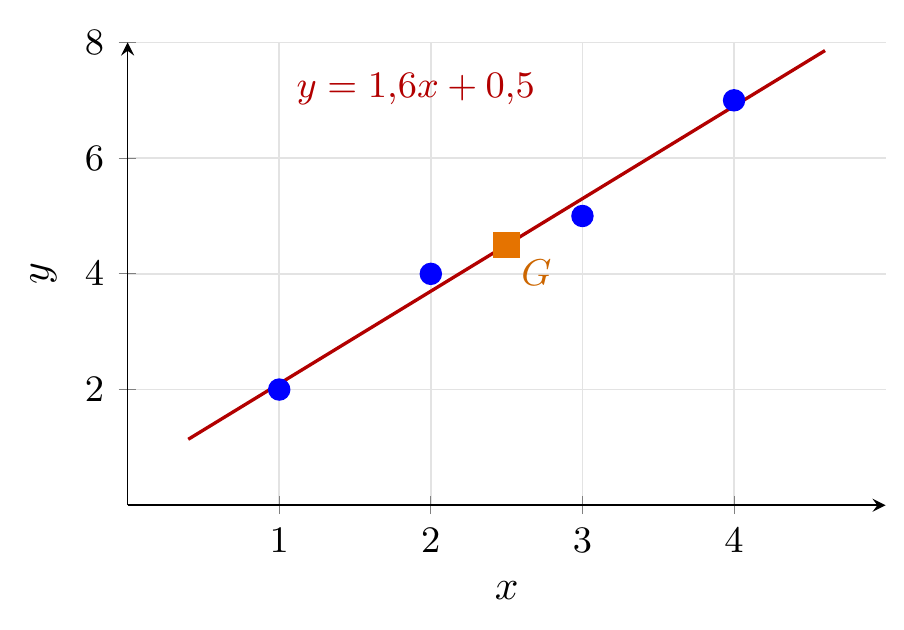
Pour un nuage de points , le point moyen est avec et .
Droite des moindres carrés de en (celle qui minimise la somme des carrés des écarts verticaux) :
Elle passe toujours par .
🔢 Méthode — Déterminer et interpréter une droite de régression
- Calculer les moyennes x̄ et ȳ : le point moyen G(x̄ ; ȳ).
- Calculer V(X) = moyenne des xᵢ² − x̄² et cov(X,Y) = moyenne des xᵢyᵢ − x̄ȳ.
- Coefficient directeur : a = cov(X,Y)/V(X).
- Ordonnée à l'origine : b = ȳ − a x̄ (la droite passe par G).
- Calculer r = cov(X,Y)/(σX σY) : |r| proche de 1 → ajustement affine pertinent.
- Interpoler ou extrapoler avec prudence : hors de la plage des données, rien ne garantit le modèle.
✏️ Exemple — Régression linéaire
✏️ Exemple — Loi exponentielle
Corrélation ≠ causalité. Deux variables peuvent être fortement corrélées sans que l'une cause l'autre : la consommation de glaces et le nombre de noyades varient ensemble, mais c'est la chaleur qui cause les deux. Un proche de mesure la qualité de l'ajustement affine, jamais un lien de cause à effet.
Pour une loi à densité, , donc : les inégalités strictes ou larges donnent la même probabilité. C'est faux pour une loi discrète, où est en général non nulle.

La droite des moindres carrés, c'est « la droite qui passe au mieux » dans le nuage : parmi toutes les droites, c'est celle qui rend minimale la somme des carrés des écarts verticaux. Cette idée de 1805 (Legendre, Gauss) est encore aujourd'hui la brique de base de l'apprentissage automatique — entraîner un modèle, c'est minimiser une erreur quadratique.
🎯 Mini-quiz
1. 90 % des malades ont un test positif. Peut-on en déduire que 90 % des personnes positives sont malades ?
2. X suit une loi exponentielle de paramètre λ = 0,5. E(X) = ?
3. Coefficient de corrélation r = −0,95. Cela signifie :
4. La droite des moindres carrés de y en x passe toujours par :